Hoe je AI-gedrag aanpast en borgt, en waarom dat een nieuwe kijk op kwaliteit vraagt.
Steeds meer software gebruikt AI-modellen die zijn aangepast aan een specifieke organisatie of vakgebied. Dat aanpassen heet fine-tuning. Maar zodra je het gedrag van een model verandert, verandert ook de kwaliteitsvraag: niet langer “werkt de functie?”, maar “gedraagt het model zich consistent, voorspelbaar en veilig?”. In dit artikel lees je wat fine-tuning is, hoe het verschilt van prompt engineering en RAG, en, minstens zo belangrijk, hoe je het resultaat risicogestuurd test en borgt met Evaluaite, het kwaliteitsframework van QA Company voor AI-systemen.
Wat is fine-tuning?
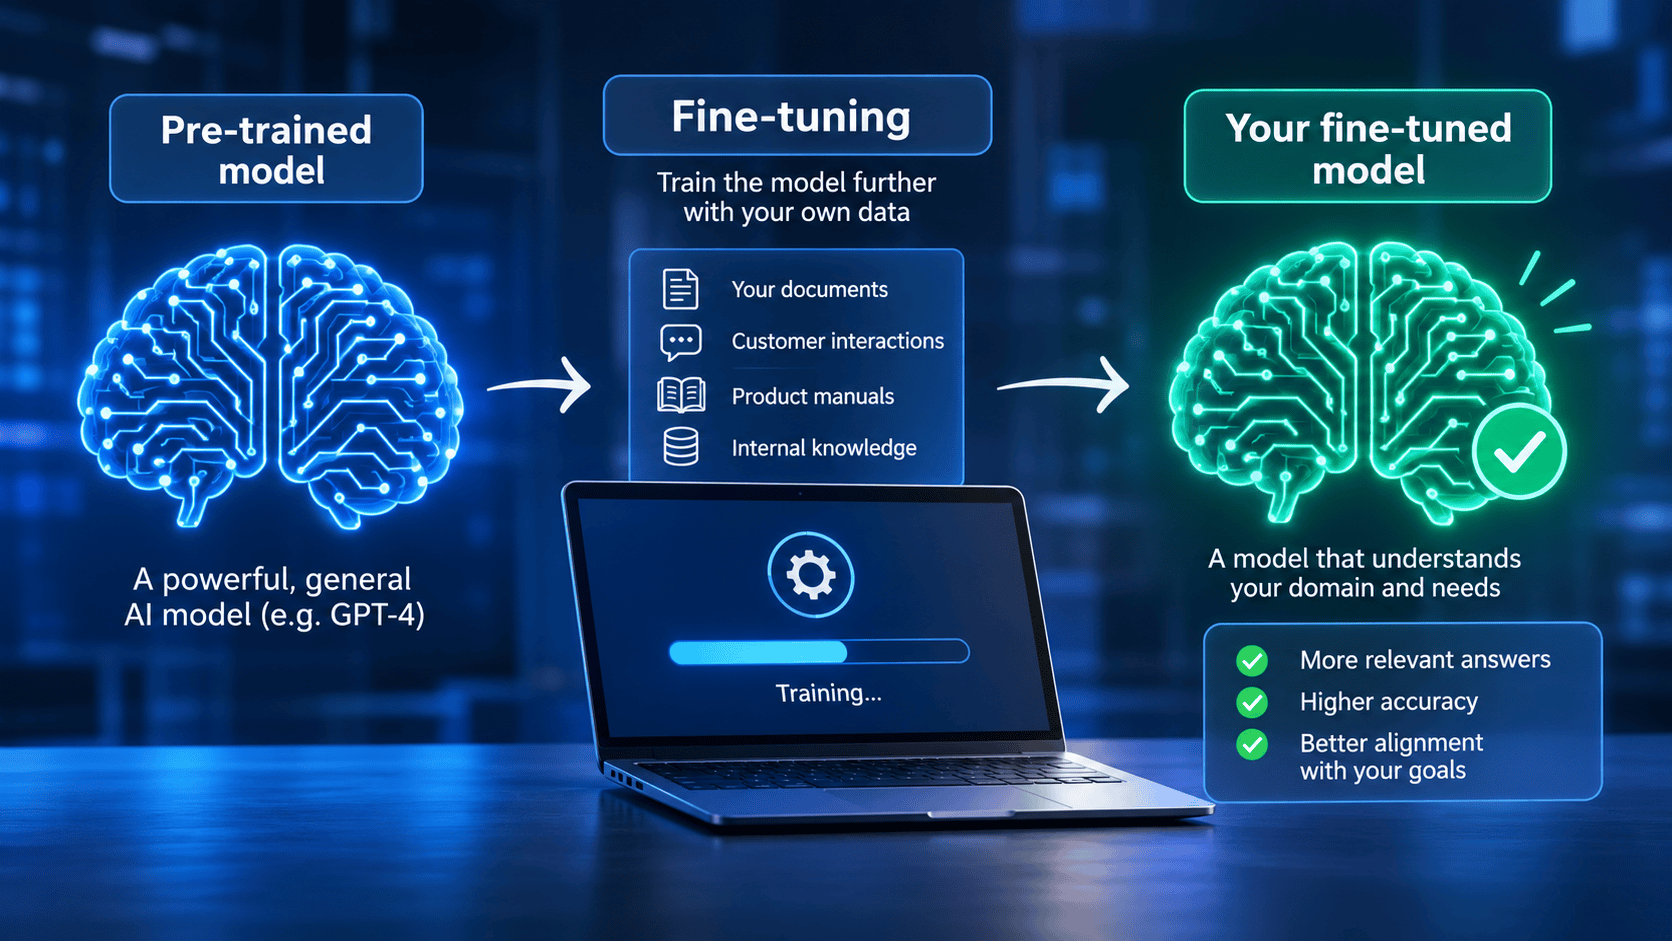
Fine-tuning is het proces waarbij je een krachtig, vooraf getraind AI-model neemt dat al algemene patronen heeft geleerd uit enorme datasets, en het beter laat presteren op een specifieke taak, een specifiek domein of een bepaalde stijl.
In plaats van een model vanaf nul te trainen, maak je als het ware de opleiding van het model af met een zorgvuldig samengestelde dataset die het doel weerspiegelt: klantenservice op maat van één organisatie, het classificeren van meldingen, het samenvatten van documenten in een vast format of het aanhouden van een herkenbare merkstem.
Algemene modellen zijn uitstekende allrounders, maar ze zijn niet automatisch goed in één specifieke taak. Een model dat op het brede internet is getraind, kent het compliance-beleid, de interne kennisbank of de exacte toon van een organisatie niet. Fine-tuning overbrugt dat gat: het stuurt de gewichten van het model bij, zodat het de stijl, het vocabulaire en de beslissingsgrenzen leert die er voor die organisatie toe doen.
Een bijgesteld model gedraagt zich anders dan het oorspronkelijke model, en dat nieuwe gedrag moet getest, gemeten en geborgd worden.
Soorten fine-tuning (en wat het voor kwaliteit betekent)
Er zijn meerdere manieren om te fine-tunen, elk met eigen afwegingen in rekenkracht, flexibiliteit en gedrag. Voor kwaliteit is vooral relevant hoe ingrijpend een methode het gedrag van een model verandert, want dat bepaalt hoeveel regressierisico er is.
Supervised fine-tuning SFT
De basismethode: je traint een model op gelabelde input-outputparen. Een veelvoorkomende variant is instruction fine-tuning, waarbij voorbeelden zijn opgemaakt als instructies met antwoorden. Veel chatmodellen (zoals ChatGPT of Claude) hebben dit ondergaan. SFT werkt goed als je duidelijke voorbeelden van correct gedrag hebt en wilt dat het model dat consistent herhaalt. Let wel: scheve of onevenwichtige voorbeelden in die trainingsdata werken net zo hard door. Bias die al in de trainingsdata sluimert, neemt het model gewoon over.
Parameter-efficient fine-tuning LoRA & QLoRA
Bij Parameter-Efficient Fine-Tuning (PEFT) laat je het grootste deel van het model met rust en train je alleen een klein, extra stukje dat ernaast wordt gezet, een soort opzetstuk. De rest van het model blijft ongewijzigd; alleen dat opzetstuk leert de nieuwe taak. Dat is veel goedkoper dan het hele model opnieuw trainen, en het werkt in de praktijk verrassend goed. Low-Rank Adaptation (LoRA) is de populairste manier om dit te doen; Quantized Low-Rank Adaptation (QLoRA) is een variant die het basismodel extra comprimeert, zodat fine-tuning ook lukt op gewone, minder krachtige hardware.
Een ander voordeel: doordat het basismodel intact blijft, kun je meerdere van die kleine opzetstukken maken voor verschillende taken en die naar wens in- en uitwisselen, zonder telkens een volledig nieuw model te trainen. Dat maakt regressie ook overzichtelijker: je weet precies welk klein onderdeel je hebt aangepast.
Full fine-tuning
Bij full fine-tuning sleutel je niet aan een klein opzetstuk, maar aan het model zelf: een groot deel, of alles, van wat het model intern heeft geleerd, wordt aangepast. Dat geeft de meeste controle over het resultaat, maar het is ook ingrijpender, en dat brengt de grootste risico’s met zich mee. Omdat je zo diep in het model veranderingen aanbrengt, loop je het risico dat het iets vergeet wat het eerder al goed kon (catastrophic forgetting), of dat zijn gedrag na verloop van tijd geleidelijk verschuift ten opzichte van wat tijdens de eerste tests werd vastgesteld (output drift).
Een model dat agressief is bijgesteld op juridische documenten, kan ineens moeite hebben met een gewoon gesprek of vergeten hoe het code moet opmaken. Houd full fine-tuning daarom achter de hand voor situaties waarin de lichtere PEFT-methoden je doelen echt niet halen, en test breed en herhaaldelijk op wat stabiel moet blijven.
PEFT (LoRA / QLoRA)
Full fine-tuning
Fine-tuning versus prompt engineering versus RAG
Fine-tuning wordt vaak verward met prompt engineering en RAG. Het zijn verschillende technieken, en elke techniek heeft voor- en nadelen. Die bepalen waar je op moet testen.
Prompt engineering stuurt het gedrag met instructies in de prompt zelf. Snel en gratis, maar star bij strikte outputformaten en gevoelig voor wisselende input. Het model heeft de eisen niet echt geleerd; het volgt alleen instructies op.
RAG (retrieval-augmented generation) haalt op het moment van de vraag relevante documenten op uit een kennisbron en voegt die toe aan de prompt. Ideaal wanneer feiten vaak veranderen. Maar de kwaliteit valt of staat met de retrieval: haalt het systeem de juiste documenten op, en gebruikt het model die correct? Gebeurt dat niet, dan ligt hallucinatie op de loer: het model presenteert dan informatie die niet in de opgehaalde bronnen terug te vinden is.
Fine-tuning verankert gedrag in het model zelf. Goed voor een consistente toon, een vast outputformaat zoals JSON, domeinspecifieke redenering en voorspelbaar gedrag. Maar de kennis is statisch: bijwerken betekent hertrainen.
In de praktijk combineren teams de methoden: RAG voor actualiteit, fine-tuning voor gedragsafstemming en prompts voor instructies per verzoek. Dat betekent ook dat een AI-functie zelden op één manier te testen is; je moet weten welke lagen erin zitten.
Snelle beslisgids
- Fine-tuningbij consistente toon, domeinredenering of voorspelbaar productgedrag.
- RAGwanneer de kennis regelmatig verandert.
- Prompt engineeringbij verkennen en prototypen.
Waarom AI testen anders werkt dan klassiek testen
Of je nu fine-tunet, RAG inzet of slimme prompts schrijft: je verandert het gedrag van een systeem dat niet-deterministisch is. Dezelfde input kan verschillende output opleveren. Daarmee vervalt de klassieke binaire benadering van goed of fout, waarop traditioneel testen leunt.
AI introduceert bovendien nieuwe risico’s, zoals stochastisch gedrag, retrieval drift, output drift, hallucinatie en inconsistente output van agents. En die risico’s manifesteren zich zelden op één plek. Een kleine variatie in de input kan leiden tot instabiele output, die vervolgens bias versterkt, verkeerde beslissingen ondersteunt of systemen verderop in de keten laat breken.
Organisaties hebben daarom een framework nodig dat risico’s expliciet maakt, kwaliteit meetbaar houdt en teams in staat stelt betrouwbare AI-functionaliteit te bouwen. Daarvoor heeft QA Company Evaluaite ontwikkeld.
Evaluaite: een risicogestuurd kwaliteitsframework voor AI
Evaluaite maakt AI-kwaliteit meetbaar, bespreekbaar en beheersbaar. Het vertrekt niet vanuit losse problemen, maar vanuit hun samenhang, en vertaalt risico’s via acht kwaliteitspijlers naar concrete evaluaties.
Input Robustness
Voorspelbaar gedrag wanneer de input varieert: consistentie, intent-stabiliteit, contextgebruik en retrieval reliability.
Output Robustness
Betrouwbare, consistente output: groundedness, feitelijke juistheid, stabiliteit, volledigheid en interoperabiliteit.
Bias & Fairness
Eerlijke, vergelijkbare kwaliteit voor groepen, talen en contexten.
Data Quality & Drift
Actuele, complete en stabiele data over tijd.
Security & Privacy
Veilig en compliant gedrag binnen duidelijke grenzen: input control, dataprotectie, access control en policy compliance.
Explainability & Transparency
Begrijpelijk, herleidbaar en uitlegbaar gedrag.
Integration & System Quality
Robuuste samenwerking met andere systemen, API’s en workflows.
Performance & Reliability
Voorspelbare prestaties en beschikbaarheid onder belasting.
De risico’s uit dit artikel sluiten bijna één op één aan op die pijlers.
| Risico | Pijler / kwaliteitsdimensie |
|---|---|
| Output drift, catastrophic forgetting | Output Robustness (stabiliteit) |
| Retrieval drift | Input Robustness (retrieval reliability) en Output Robustness (groundedness) |
| Hallucinatie | Output Robustness (groundedness) |
| Vast outputformaat (zoals JSON), consistente toon | Output Robustness (interoperabiliteit en stabiliteit) |
| Bias uit trainingsdata | Bias & Fairness |
| Verouderde of scheve data | Data Quality & Drift |
| Prompt injection, datalekken | Security & Privacy |
Van risico naar beslissing: de werking van Evaluaite
Binnen elke pijler koppelt Evaluaite een specifiek risico aan een kwaliteitsdimensie en aan een meetbare metric. Zo wordt gedrag dat eerst alleen “aanvoelde” ineens stuurbaar.
Neem Output Robustness. Het risico van hallucinatie vertaalt zich naar de dimensie groundedness, gemeten met een Groundedness Score die zichtbaar maakt of output te herleiden is naar beschikbare context of bronnen. Niet om te bewijzen dat iets goed is, maar om onbetrouwbaar gedrag zichtbaar te maken voordat het in productie tot problemen leidt.
Metrics laten het gedrag zien; thresholds maken kwaliteit stuurbaar. Een threshold definieert welk gedrag acceptabel is en wanneer ingrijpen nodig is. Daarmee verschuift AI-kwaliteit van interpretatie naar besluitvorming: teams nemen onderbouwde acceptatiebeslissingen, zetten human-in-the-loop gerichter in en kunnen kwaliteitsbewaking automatiseren en monitoren.
De Risk Strip In een paar minuten
Het startpunt is de Risk Strip, een lichte analyse waarmee een team in een paar minuten de relevante risico’s identificeert:
Teams selecteren de risico’s; Evaluaite neemt het vanaf daar over.
Evaluation-Driven Development
Omdat AI-systemen probabilistisch zijn, verschuift de focus van puur deterministisch testen naar het evalueren van stabiliteit, robuustheid en voorspelbaarheid.
- Harde asserts
- Absolute waarheden
- Binair: goed of fout
- Sturen op evaluaties
- Werken met thresholds
- Meten hoe consistent en betrouwbaar een model presteert
Omdat Evaluaite past in moderne ontwikkelprocessen, kun je die evaluaties continu in de CI/CD-pipeline draaien, zodat kwaliteit meegroeit terwijl het systeem evolueert.
Wat het jouw team oplevert
Zonder een expliciet kwaliteitsframework voor AI belanden teams vaak in discussies op basis van onderbuikgevoel. Evaluaite doorbreekt dat patroon.
- Discussies op basis van onderbuikgevoel
- Onzekerheid over wat acceptabel AI-gedrag eigenlijk is
- Testinspanning zonder duidelijke prioriteit
- Beslissingen die te laat worden genomen
- Betere ontwerpkeuzes
- Een geprioriteerde QA- en teststrategie
- Duidelijke beslissingen over acceptatie, monitoring en doorontwikkeling
- Kwaliteit die vooraf wordt gestuurd
Kort gezegd: inzicht en grip op AI-kwaliteit.
Van “kan het werken?” naar “kunnen we erop vertrouwen?”
Die verschuiving is geen onderbuikgevoel. Wij zien dit bij klanten gebeuren. Onderzoeksbureau Gartner verwacht dat eind 2026 ongeveer 40% van alle bedrijfsapplicaties een AI-agent bevat, tegen minder dan 5% een jaar eerder.[1]
Maar uit hetzelfde soort onderzoek (onder meer van Forrester[2] en MIT[3]) blijkt ook dat een groot deel van de AI-pilots nooit de stap naar productie maakt, vaak juist omdat de betrouwbaarheid en governance niet op orde zijn. Daarmee verschuift de vraag van “kan het werken?” naar “kunnen we erop vertrouwen?”. Dat is bij uitstek een kwaliteitsvraag. Of je nu een gefine-tuned model in je software inbouwt of AI inzet om je werk te versnellen: consistent, voorspelbaar en veilig gedrag borg je met een gestructureerde, risicogestuurde aanpak.
Evaluaite is het risicogestuurde kwaliteitsframework van QA Company voor AI-systemen. Wij ondersteunen de implementatie in vier fasen:
Kwaliteitsfundament neerzetten
Inbedden in bestaande workflows
Continue evaluaties in de CI/CD-pipeline
Coaching naar een duurzame kwaliteitsmindset
Meer weten over Evaluaite?
Neem contact op om te ontdekken hoe je AI-kwaliteit binnen jouw team meetbaar en beheersbaar maakt.
Bronnen
- Gartner, “Gartner Predicts 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026, Up From Less Than 5% in 2025”, augustus 2025: gartner.com/en/newsroom/press-releases
- Forrester, geciteerd in: ITPro, “IT leaders are bullish on agents, but keep falling at the final hurdle”, 2026: itpro.com
- MIT NANDA (Project NANDA), “The GenAI Divide: State of AI in Business 2025”, juli 2025, zoals gerapporteerd door Fortune: fortune.com